基于AI的微信阅读答题答案糊脸-WeReaderQA
开发背景
事情还要从微信阅读说起,微信阅读的云存档和AI阅读很好用,界面美观,也有一些不错的书籍(PS:没有的话直接zlibrary下载导入蹭云存档,爽的雅痞),但是这些功能都要会员才行,而关于会员,微信阅读有两种答题活动,其中一种每天可以免费参与一次,共12题,题目涵盖的知识范围十分广泛,成功会送1天体验卡,这个体验卡攒满60张+6元可以换30天会员;另一种答题每天只能参加一次且需要付费1元参加,也是12道题,题目和上面的差不太多,成功后依据计时结束 成功人数/总参加人数 的比值来确定奖励,一般都是3-4天会员。
所以粗略估算下,相当于第一个答题:60体验卡(刷30天左右)+ 6元 = 30天会员,也就是需要6元30天会员;第二个答题 :4天会员(单次答题奖励,需1元)x 7次 = 28天会员,也就是7元28天会员。
乍一看差不多,但是第二个更贵一点,同时更灵活一些,因为第二种方案可以看做动态会员充值,1元充4天,对于那些看书不太连贯的用户来说更划算。
那么问题来了,由于题目考察的内容涵盖范围太广,并不是所有人都能快速准确地答对,也就是说像笔者这种笨笨大概率是要当炮灰的,因此,秉着工欲善其事必先利其器的作风,笔者打算做一个实时显示答案的脚本以便借鉴一二(PS:你最好是在借鉴~),以此实现会员滚会员的低价会员永动机!
需求分析
核心痛点:
作为一名菜鸡用户,面对考察知识范围如此广阔的题目无能为力,只能瞎蒙,根本做不对啊喂!
需求:
本质上做对题就行。
如何做对题呢?想想学生时代做练习册的场景,那莫过于直接翻答案了,所以能拿到答案就是胜利!
分析:
每道题只有 12s 答题时间,每次换题后用户反应时间消耗 2s,用户答题时间留 4s(PS:问就是要考虑反映最慢的用户群体,没错就是我~),就剩 6s 了,再加上一些不确定因素比如偶尔发愣啥的,对及时性要求很高。因此从开始处理到显示答案要限制在 6s 之内。
解决方案
首先来看一下答题过程:

可以看到答题框大小还不固定,但是四周还是比较干净的。
大致有一个思路,获取题目,然后调用 AI 获取到答案,然后将答案显示在终端。如何获取题目?我能想到的有两个方案,一是捕捉到答题窗口实时获取截图,二是利用ADB直接获取截图。从稳定性和速度上来看,显然ADB的方式更合适(PS:问就是捕捉窗口还要抓进程,好麻烦,我比较懒)。
然后就是从图片提取文字信息了,那肯定是OCR图像文本识别啦!但是相关的OCR库很多,特点各不相同。我们要处理的图像的文本,有数字,有中文,英文应该是不需要的。所以以中文识别为主。
然后就是AI,目前主流AI有DeepSeek、Grok、Gemini、ChatGPT、Claude。但是国外这几个要付费,付费方式暂时无法解决,只能选用DeepSeek + Gemini Flash。DeepSeek官方的API反应速度很慢很慢很慢,因此采用了硅基流动的DS API。而谷歌的Gemini Flash 2.0 虽然准确度没DeepSeek好,但是它快,特别快,平均 1s 就能返回结果。具体还要看应用场景,适时调整使用好了。
综上呢,可以细化一下这个方案:
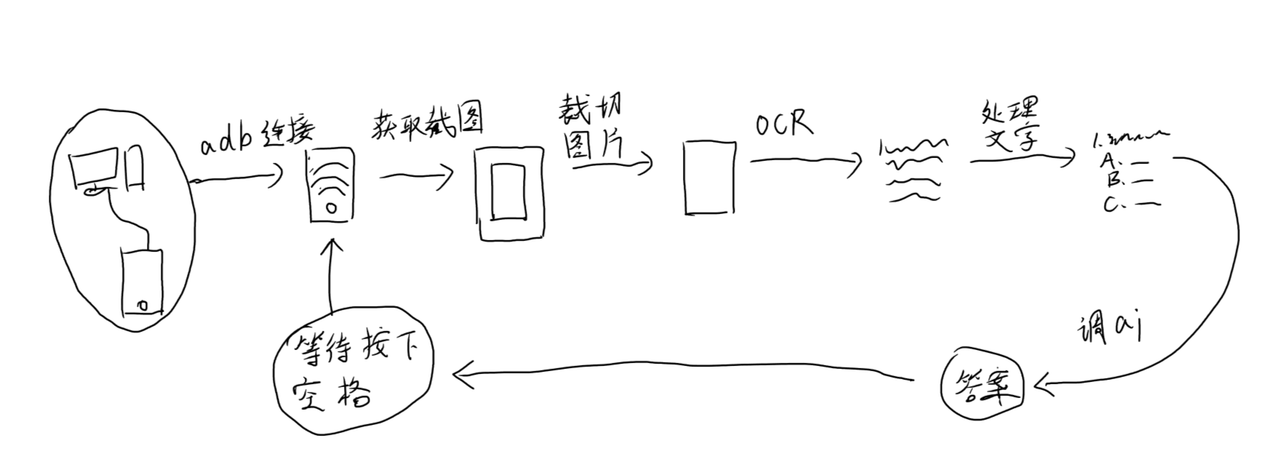
- 利用 ADB 连接手机。
- 通过 ADB 将手机截图传到电脑。
- 脚本裁切截图。
- 对裁切后的图片进行 OCR 识别。
- 整理 OCR 后的文字排为题目+答案格式。
- 调用 AI 返回该题目答案。
有了基本流程后我们还要想一想,首先这一套流程所需要的时间大概5s左右,那么如果让他全自动执行,不断地传回截图返回答案,如果是在切换题目的过程应该怎么办,那时候题目可能只显示了一半,另外两个题目之间的答题间隔也不一样,所以让他全自动不断识别查询不太可行。
因此想了折中方案,当程序运行,用户需要按空格才能触发该流程,且按一次空格触发一次,也就是说每次新题目显示出来,都需要用户按一下空格才开始分析查询,虽然看起来麻烦,但胜在流程全自动化而且效率可以改进,速度可以提升,总的来说还是很方便的,毕竟这要比直接谷歌百度来的快捷方便。
大致流程如下:
技术选型
关于AI:首先本质上,我们就是要用 AI 来解决问题的,目前主流的AI有Gemini、Grok、Claude、Deepseek,前几个都是国外AI,好用是好用,但是限于条件没办法充值,因此只能选用Deepseek。另外笔者一贯作风就是物尽其用,尽管Deepseek并不太好用,但是在这种知识问答方面还是挺擅长方便的,而且也足够便宜。
关于编程语言:这个就更简单了,直接选择Python,然后辅以适当优化,开发效率会很高。
关于OCR:
特性/库 CnOcr PaddleOCR easyocr 核心优势 轻量、快速、部署简单 精度极高、功能全面(含版面分析) 极其易用、多语言混合识别方便 模型大小 小 (几十MB) 大 (数百MB) 中等 安装部署 简单 (纯Python) 较复杂 (依赖PaddlePaddle框架) 非常简单 中文精度 高 (适用于常规场景) 极高 (适用于复杂场景) 中等 (不如前两者) 主要缺点 功能单一,复杂场景效果差 资源消耗大,依赖重 中文精度相对不足,速度一般 推荐场景 服务器、个人项目:对资源有限制,且场景相对常规。 企业级应用、研究:追求最高精度,需要版面分析等高级功能。 快速原型开发、入门学习:需要快速实现OCR功能,或处理中英混合文本。 基于此呢,我选择使用CnOCR,当然也是实际测试过效果才使用的。
Python(编程语言) + Deepseek(AI模型) + CnOCR(图像文字识别)
核心功能的难点与实现
整体实现难度不大,问题在于刚开始效率过慢,仔细检查后才发现是官方deepseek api响应过慢导致的,后续换了其他源,gemini 2 flash,硅基流动的ds api,这俩速度都可以,官方平均5s,这俩只要2s。
下面是调用ai的方法:
调用官方 DeepSeek
1 | def get_answer_by_deepseek_simple(question): |
调用硅基流动 Deepseek
1 | def get_answer_by_qwen_qwq_32_simple(question): |
调用 Gemini 2.0 flash
1 | def get_answer_by_gemini(question): |
项目演示
答题页面:
(PS:受限于gif和图床,只能用这种战损级画质~)

AI分析糊脸演示:

效益
把我从一个无知的笨笨提升到了学者级别!(PS:临时性Buff)
OCR准确率高达 98%(PS:当然笔者贴心的将识别出来的杂文本过滤掉了,总之呢,结果就是这样滴)
答题准确率由原来的笨笨级别提升到了学者级别,emmmm,大概是 ??->95% 准确率的样子。
复盘
整个过程,难点在于选用合适的OCR以及AI API。
最终,OCR使用CnOcr,这个大模型训练出来的比较好用,速度也不错。
AI api用了Gemini flash 2.0、官方Deepseek、硅基流动Deepseek。
不同模型响应速度差别太大了,Gemini最快,但是有些题目识别不准,准确率欠缺,官方Deepseek响应速度过慢,平均6秒;硅基流动的Deepseek接口稍微快点,平均2s。
这次发现了个好用的OCR,其他的话就是在实战上体验了不同模型的差别。
- 标题: 基于AI的微信阅读答题答案糊脸-WeReaderQA
- 作者: 起风了
- 创建于 : 2025-06-24 20:23:43
- 更新于 : 2026-09-25 23:19:35
- 链接: https://www.wangcac.me/2025/06/24/基于AI的微信阅读答题答案糊脸-WeReaderQA/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。